
BigQuery
Un entrepôt de données Data Studio conçu et exploité par notre équipe
Nous concevons et exploitons dans BigQuery un entrepôt de données Data Studio pour les entreprises dont le reporting a dépassé les connecteurs directs et les fusions. Vous obtenez des tables propres et modélisées que tous les tableaux de bord lisent, des flux depuis vos outils SaaS, et des coûts et accès sous contrôle, sans recruter une équipe d’ingénierie des données.
Réponse rapide
Quand a-t-on besoin d’un entrepôt de données pour Data Studio ?
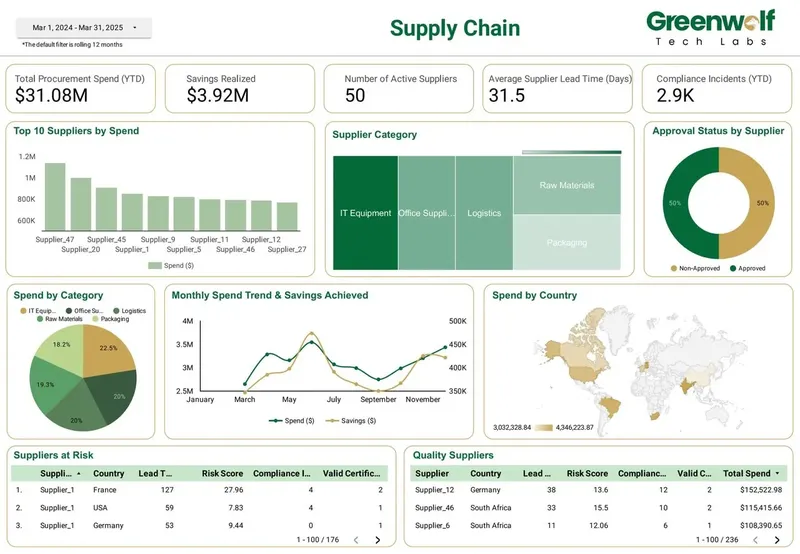
Vous avez besoin d’un entrepôt de données pour Data Studio lorsque vos rapports rencontrent des erreurs de quota GA4, des erreurs « trop de lignes » ou des pages lentes, lorsque des fusions nécessitent plus de 5 sources, ou lorsque le même indicateur est calculé différemment d’un rapport à l’autre. BigQuery offre à chaque tableau de bord une source unique, rapide et modélisée.
- BigQuery devient la source modélisée unique que lisent tous les rapports Data Studio.
- Les tables partitionnées et les requêtes planifiées gardent les tableaux de bord rapides et les coûts de requête prévisibles.
- Les flux réunissent plateformes publicitaires, CRM, boutiques en ligne et exports comptables en un seul endroit.
- Un modèle propre est aussi ce dont les agents de données de Conversational Analytics ont besoin pour répondre juste.
Comment savoir si vos données ont dépassé les connecteurs ?
Les signes sont généralement des erreurs, de la lenteur et des désaccords sur les chiffres. Les connecteurs directs conviennent pour une ou deux sources, mais ils interrogent le système source chaque fois que quelqu’un ouvre une page, ce qui ne tient pas à l’échelle.
Voici les symptômes que nous voyons le plus souvent chez les entreprises qui viennent nous voir :
- Des erreurs de quota GA4, la limite standard de la Data API étant de 14 000 jetons par projet, par propriété et par heure.
- Des erreurs « trop de lignes » sur les grandes tables, ou des pages qui mettent de longues secondes à se charger.
- Des fusions qui nécessitent plus de 5 sources, ou des jointures qui ne sont pas de simples correspondances d’égalité.
- Des connecteurs à schéma fixe qui plafonnent une table à 10 dimensions et 20 métriques.
- Le même KPI calculé dans trois rapports, avec trois résultats différents.
À quoi ressemble un entrepôt de données Data Studio dans BigQuery ?
Il comporte trois couches : les données brutes telles qu’elles arrivent, des tables nettoyées et harmonisées, et des tables de reporting conçues pour les tableaux de bord. Data Studio ne lit jamais que la dernière couche.
Les tables brutes conservent chaque source telle quelle, pour que rien ne soit perdu et que tout calcul puisse être relancé. La couche nettoyée renomme les champs, corrige les types, convertit les devises et supprime les doublons. La couche de reporting contient des tables construites autour des questions : dépenses et conversions quotidiennes par canal, lignes de commande avec marge, table financière mensuelle par groupe de comptes. BigQuery étant une source à schéma flexible, ces tables peuvent porter jusqu’à 100 dimensions et 100 métriques par tableau Data Studio, bien au-delà des plafonds des schémas fixes.
Ce que vous obtenez
Ce que nous réalisons
Périmètre et prix forfaitaire définis après un audit gratuit.
Projet BigQuery
Des ensembles de données pour les couches brute, nettoyée et de reporting, créés dans votre propre compte Google Cloud.
Flux de sources
Des chargements planifiés depuis Google, des connecteurs partenaires et des exports de fichiers, avec contrôles de fraîcheur.
Tables de reporting
Des tables partitionnées et clusterisées, construites par des requêtes planifiées pour chaque tableau de bord.
Modèle d’accès
Des rôles IAM par ensemble de données, plus des règles au niveau des lignes lorsque les lecteurs doivent voir des données restreintes.
Maîtrise des coûts
Des alertes budgétaires et une revue des coûts de requête après le premier mois.
Dictionnaire de données
Chaque table et chaque champ décrits, avec les définitions des indicateurs et leurs responsables.
Tableaux de bord rebranchés
Vos rapports Data Studio passés des connecteurs directs et des fusions aux nouvelles tables.
Comment faire entrer les données des outils SaaS dans BigQuery ?
Nous utilisons pour chaque source la voie fiable la plus simple. Les sources Google comme GA4 et Google Ads disposent de leurs propres exports et transferts vers BigQuery. Pour Meta, LinkedIn, TikTok, Shopify, HubSpot et les outils similaires, des connecteurs partenaires comme Supermetrics, Windsor.ai, Funnel ou Power My Analytics peuvent écrire dans BigQuery selon un calendrier.
Les logiciels comptables et les outils internes ne proposent souvent que des exports de fichiers : nous les déposons dans Google Drive ou Cloud Storage et les chargeons selon un calendrier. Chaque flux est doté d’un contrôle de fraîcheur qui enregistre la dernière date chargée, car un flux qui échoue en silence est pire qu’un flux qui échoue bruyamment.
Nous chargeons aussi l’historique lorsque la source le permet, pour que les courbes de tendance démarrent avec un contexte utile plutôt que le jour de la mise en service de l’entrepôt. Lorsqu’une source ne conserve qu’une fenêtre limitée, nous le disons d’emblée et commençons la collecte dès le premier jour.
Comment le partitionnement et les requêtes planifiées réduisent-ils les coûts ?
BigQuery facture principalement le volume de données parcouru par chaque requête : le modèle est donc conçu pour en parcourir le moins possible. Partitionner les tables par date signifie qu’un tableau de bord affichant les 30 derniers jours lit 30 jours de données, pas cinq ans.
Nous ajoutons un clustering sur les champs les plus filtrés, comme le canal, la région ou le client, et utilisons des requêtes planifiées pour construire des tables de reporting compactes une fois par jour, au lieu de laisser chaque graphique exécuter en direct de lourdes jointures. Les commandes de période dans Data Studio sont réglées par défaut sur des durées raisonnables. Nous configurons aussi des alertes budgétaires et examinons les requêtes les plus coûteuses le premier mois, pour que les coûts soient compris avant d’augmenter.
Comment l’accès est-il gouverné dans l’entrepôt ?
L’accès est défini au niveau des ensembles de données et des tables dans Google Cloud IAM, et Data Studio le respecte. Les ensembles de données bruts sont réservés aux flux et à notre équipe ; les ensembles de reporting sont ouverts aux personnes qui en ont besoin.
Lorsque les lecteurs ne doivent voir que leurs propres lignes, par exemple un responsable régional qui ne voit qu’une région, les sources BigQuery utilisent les identifiants du lecteur avec des règles au niveau des lignes, et le tableau de bord n’affiche à chacun que ses données. Avec Data Studio Pro, les rapports appartiennent à l’entreprise via un projet Google Cloud et IAM, avec journaux d’audit, CMEK et options de localisation des données pour les entreprises qui en ont besoin.
Un entrepôt aide-t-il pour Conversational Analytics ?
Oui, et c’est même une condition. Conversational Analytics dans Data Studio, disponible pour tous depuis le 30 juillet 2026, répond aux questions grâce à des agents de données construits dans BigQuery et publiés dans Data Studio.
Un agent ne peut être plus juste que les tables vers lesquelles il pointe. Des noms de tables clairs, des colonnes documentées, une ligne par niveau de granularité clairement défini et des définitions d’indicateurs validées : c’est exactement ce qu’un entrepôt bien construit possède déjà. Les entreprises qui modélisent d’abord leurs données sont celles qui obtiennent des réponses utiles lorsqu’elles activent la fonctionnalité.
S’agit-il d’un projet ou d’un travail continu ?
Les deux, successivement. La construction est un projet à prix fixe : flux, modèle, tables de reporting et tableaux de bord qui les lisent, plus la documentation de chaque table et de chaque champ.
Après la mise en service, les sources évoluent. Les plateformes publicitaires renomment des champs, une nouvelle boutique ou une nouvelle entité s’ajoute, et la direction pose de nouvelles questions. Beaucoup de clients nous gardent dans le cadre d’un service mensuel géré pour surveiller les flux, étendre le modèle et maîtriser les coûts. D’autres reprennent l’ensemble grâce à notre documentation et nous appellent lorsqu’un nouveau besoin apparaît.
Fonctionnement
Déroulement d’un projet
- 01
Audit gratuit
Nous examinons vos sources, vos rapports actuels et les erreurs ou lenteurs que vous rencontrez.
- 02
Conception du modèle
Nous définissons avec vous les tables de reporting, les définitions des indicateurs et les règles d’accès.
- 03
Flux
Nous connectons chaque source à BigQuery et chargeons l’historique.
- 04
Réalisation et rapprochement
Nous construisons les tables, rebranchons les tableaux de bord et vérifions les totaux par rapport à chaque source.
- 05
Passation ou gestion
Nous documentons tout, puis vous remettons l’ensemble ou l’exploitons chaque mois.
FAQ
Questions fréquentes
Pourquoi utiliser BigQuery avec Data Studio ?
BigQuery offre à Data Studio une source unique, rapide et modélisée au lieu de nombreux connecteurs en direct. Il supprime les limites des fusions et les erreurs de quota GA4, et permet à chaque rapport d’utiliser les mêmes définitions d’indicateurs.
Combien coûte BigQuery pour une configuration Data Studio ?
Le coût dépend surtout du volume de données parcouru par les requêtes et du volume stocké. Le partitionnement, le clustering et des tables de reporting préconstruites limitent les volumes parcourus, et nous configurons des alertes budgétaires pour éviter les surprises.
L’entrepôt est-il hébergé dans notre compte Google Cloud ?
Oui. Nous construisons dans votre projet : vous êtes propriétaire des données, des tables et de la facturation. Notre équipe travaille avec les accès que vous accordez et pouvez retirer à tout moment.
BigQuery peut-il récupérer des données de Meta, Shopify ou HubSpot ?
Oui, via des connecteurs partenaires qui écrivent dans BigQuery selon un calendrier, ou via des exports. Nous choisissons la voie source par source selon la fiabilité et le coût.
Faut-il un data engineer pour le faire fonctionner ?
En général, non. Les flux sont planifiés et surveillés, et la documentation couvre les corrections courantes. Beaucoup de clients choisissent notre formule de reporting géré plutôt que de recruter.
BigQuery est-il surdimensionné pour une petite entreprise ?
Parfois. Si vous avez deux ou trois sources et aucun problème de quota ni de vitesse, Google Sheets et des connecteurs directs peuvent suffire, et nous vous le dirons lors de l’audit. L’entrepôt se justifie lorsque les sources, les volumes ou les désaccords sur les chiffres augmentent.
Nos rapports Data Studio existants fonctionneront-ils toujours ?
Oui. Nous les rebranchons sur les nouvelles tables BigQuery, conservons les mises en page que votre équipe connaît et rapprochons les totaux avant la bascule.
À lire aussi
Pages associées
Commencer
Dites-nous ce que votre reporting doit accomplir
Décrivez les tableaux de bord dont vous avez besoin, leurs lecteurs et l’emplacement de vos données. Nous répondons sous un jour ouvré avec une approche, les connecteurs nécessaires et un plan à prix fixe.
- Audit gratuit de 30 minutes de votre reporting
- Devis ferme avant tout démarrage
- Tout est créé dans votre compte Google et vous appartient
Vous préférez l’e-mail ? info@greenwolftechlabs.com
Demander une proposition gratuite
Deux lignes suffisent pour commencer.